Van lysaat naar sequentiedata: sequencing en bio-informatica
Nadat het DNA uit de cellen is vrijgekomen en gezuiverd, begint het lezen. De gekozen sequencingmethode en analysepijplijn bepalen hoeveel detail een darmtest uiteindelijk laat zien.
Markergenen versus shotgun metagenomics
- 16S rRNA-sequencing (en ITS voor schimmels) leest één specifiek markergen. Deze aanpak is kostenefficiënt en geschikt voor grote aantallen monsters, maar levert meestal informatie op genusniveau en geen functionele informatie.
- Shotgun metagenomics sequenseert al het DNA in het monster. Dat geeft soorts- en soms stamniveau, plus inzicht in genen en potentiële functies, tegen hogere kosten en meer rekenwerk.
Voor toepassingen waarin functionele interpretatie belangrijk is, wordt shotgun metagenomics steeds vaker gekozen. 16S-sequencing blijft nuttig voor grootschalige screenings en populatiestudies.
Sequencingplatforms en lezenstypes
Short-read platformen zoals Illumina leveren hoge nauwkeurigheid en doorvoer en zijn daardoor geschikt voor taxonomische overzichten en genanalyse. Long-read platformen zoals Oxford Nanopore en PacBio zijn sterker in het samenstellen van genomen, het detecteren van structurele variatie en het koppelen van genen aan specifieke stammen. De beste keuze hangt af van de vraag: routinematige profilering vraagt vooral om een goede balans tussen kosten, nauwkeurigheid en interpreteerbaarheid, terwijl stamresolutie of epidemiologische tracking aanvulling met long reads kan rechtvaardigen.
Voorbij DNA: RNA, eiwitten en metabolieten
- Metatranscriptomics laat zien welke genen actief tot expressie komen.
- Metaproteomics meet welke eiwitten daadwerkelijk aanwezig zijn.
- Metabolomics meet de stoffen die microben produceren, zoals korteketenvetzuren.
Door deze lagen te combineren wordt de kloof tussen potentieel en werkelijke activiteit kleiner. Zulke multi-omics verbanden zijn verkennend en vragen om validatie in goed opgezette studies.
Kwaliteitscontrole en taxonomische profilering
De eerste bio-informaticastappen zijn het trimmen van adapters, filteren van reads met lage kwaliteit en verwijderen van humaan DNA. Maten zoals leesdiepte, duplicatiepercentages en diversiteitsindexen geven aan of een monster geschikt is voor verdere analyse. Daarna koppelt taxonomische classificatie reads aan microben, van domein tot soort of stam. Veelgebruikte benaderingen zijn:
- aligneren tegen referentiedatabases zoals SILVA, GTDB of RefSeq;
- op markers gebaseerde methoden die specifieke genregio's gebruiken;
- op k-mers gebaseerde classifiers die patronen in korte sequentiestukjes herkennen.
De gekozen database en de versie ervan beïnvloeden nauwkeurigheid en resolutie. Regelmatige updates en zorgvuldige curatie zijn nodig om nieuwe taxa te herkennen en misclassificaties te beperken.
Functionele analyse en stamresolutie
Functionele analyse koppelt genen aan routes en enzymfuncties, met bronnen als KEGG, EggNOG, UniProt en MetaCyc. Zo wordt zichtbaar welke functies aanwezig kunnen zijn, bijvoorbeeld vezelafbraak tot korteketenvetzuren, productie van vitaminen of interacties met het immuunsysteem van de gastheer. Functioneel potentieel op basis van DNA is een aanwijzing, geen bewijs van activiteit: expressiegegevens of metabolietmetingen zijn nodig om te bevestigen wat microben daadwerkelijk doen.
Verschillen binnen één soort kunnen relevant zijn, bijvoorbeeld wanneer nauw verwante stammen verschillen in pathogeniciteit. Met metagenoom-geassembleerde genomen (MAGs) kunnen bijna volledige genomen uit complexe monsters worden gereconstrueerd, wat epidemiologische tracking en diepgaander inzicht in microbiële ecologie ondersteunt.
Rapportage en reproduceerbaarheid
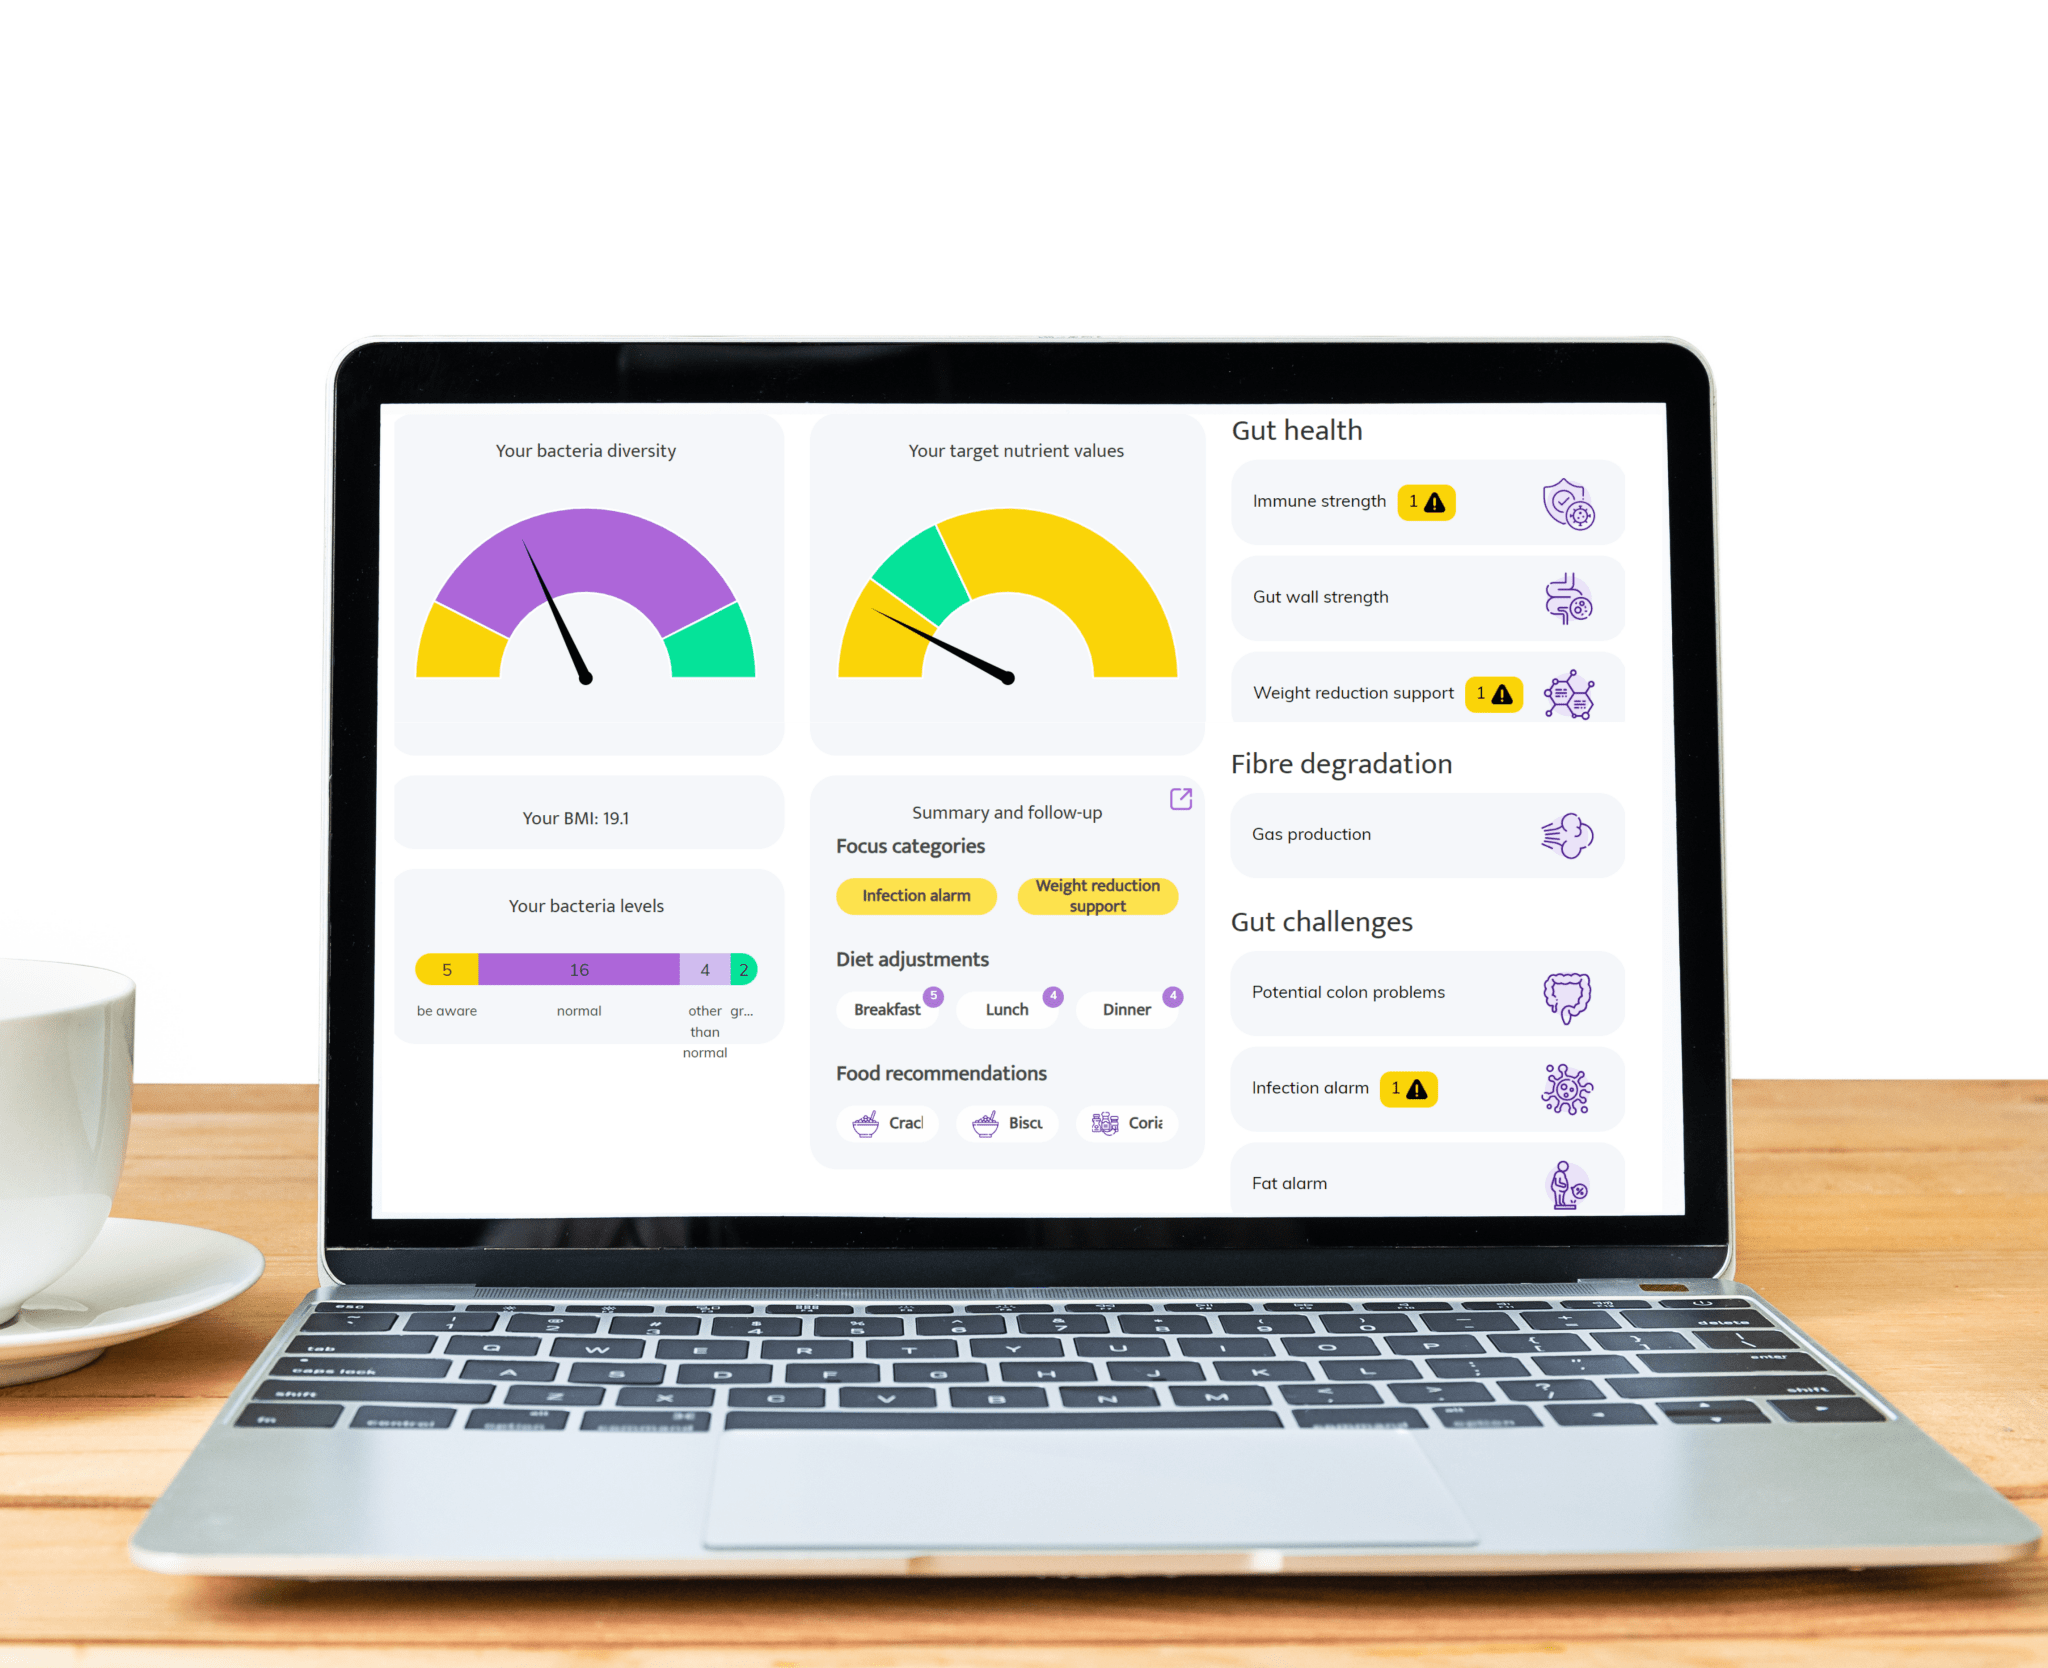
Gestandaardiseerde rapportageformaten en reproduceerbare pijplijnen maken studies onderling vergelijkbaar. Containerisatie (Docker, Singularity) en workflow-managers (Nextflow, Snakemake) helpen om resultaten te herhalen. Voor klinisch gebruik moeten pijplijnen gedocumenteerd en gevalideerd zijn, zodat rapporten aan de eisen voldoen en clinici de uitkomsten goed kunnen plaatsen. De keuze van pijplijn, databaseversie en statistische drempels bepaalt mede wat een rapport wel en niet kan zeggen.